

티스토리 뷰
주말 사이 개발자 커뮤니티를 뜨겁게 달군 모델이 하나 있다.
TypeSafe AI라는 곳에서 낸 Jev 인데 System One 모델이라는 새 이름까지 붙여서 내놨다.
https://docs.typesafe.ai/introduction (얘네 홈페이지를 너무 러프하게 만들어서 docs에서 보는게 편함)
다른 LLM과의 가장 큰 차이는 문장을 안 만든다는 것이다. 가입하면 크레딧을 5달러 주길래 이것 저것 테스트 해봤다.
한글이 되는지, 얼마나 쓸 수 있는지, 뭘 시킬 만한지 순서로 적어둔다. 가입부터 첫 호출까지 10분이면 되니 관심 있으면 직접 해보는 게 빠르다.
System One Model : Jev
보통 모델한테 "이 문의 어느 팀으로 보낼까"라고 물으면 이렇게 답한다.
"결제 관련 문의로 보이므로 결제팀에서 처리하는 것이 적절합니다."틀린 답은 아닌데 프로그램 입장에선 곤란하다. 이 문장에서 "결제팀"을 꺼내는 코드를 따로 짜야 하고, 어떤 날은 "결제 팀"이라고 띄어 쓰고, 가끔은 있지도 않은 팀 이름을 지어낸다. 한 번쯤 겪어봤을 것이다.
Jev는 문장 대신 이렇게 준다.
  결제팀      1.0
  기술지원팀  0.0
  계정팀      0.0
객관식 답안지에 표시만 하는 셈이다. 꺼낼 것도 없고, 목록에 없는 답이 나올 수도 없다. 선택지를 미리 주고 그 안에서만 고르게 만든 구조라서다.
빠른 이유도 여기 있다. 문장을 만들려면 글자를 하나씩 이어 붙여야 하는데, 객관식은 한 번에 계산하면 끝난다.
물어볼 수 있는 건 세 가지뿐이다.
  noul     예/아니오          확률 하나로 돌아온다
  score    몇 단계짜리 척도    어느 단계인지 소수로 돌아온다
  choice   여럿 중 하나       고른 것 + 선택지별 확률
회원 가입 후, 플레이그라운드에 들어가면 이 셋이 빈 양식으로 놓여 있다. choice는 이렇게 생겼다.
{
  "new_choice_1": {
    "type": "choice",
    "instructions": "Which option best fits the state?",
    "criteria": {
      "option_a": "Description of an option",
      "option_b": "Another description of a distinct option",
      "option_c": "Another mutually exclusive option"
    }
  }
}
score 양식의 기본 문구가 재밌다. "한 축의 가장 낮은 단계 / 같은 축의 중간 / 같은 축의 가장 높은 단계"라고 적혀 있다. 그냥 예시가 아니라 규칙을 말해주는 거다. 단계들이 전부 같은 축 위에 순서대로 놓여야 한다. 성격이 다른 항목을 섞으면 척도가 아니라 객관식이 된다.
판단할 재료는 state로 따로 넣고, 질문은 여러 개를 한꺼번에 붙일 수 있다.
가입하고 키 받기
가입한 뒤 API Keys에서 키를 하나 만들면 끝이다. 카드 등록 같은 건 없다.
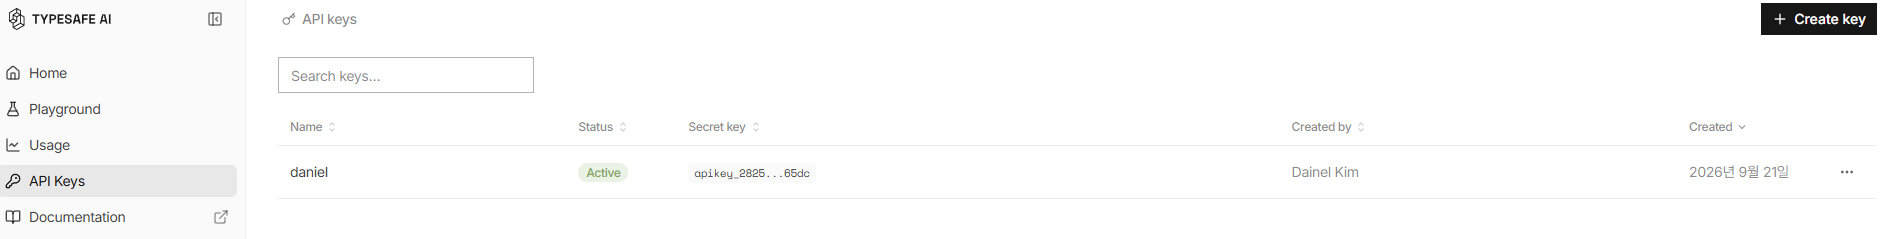
만들면 목록에 뜨는데 여기서는 앞뒤 몇 글자만 보인다. 전체 값은 만드는 순간 한 번만 보여주니 그때 복사해둬야 한다.
가입하면 5달러가 들어와 있다. Monthly credit이라고 적혀 있고 만료는 한 달 뒤다.
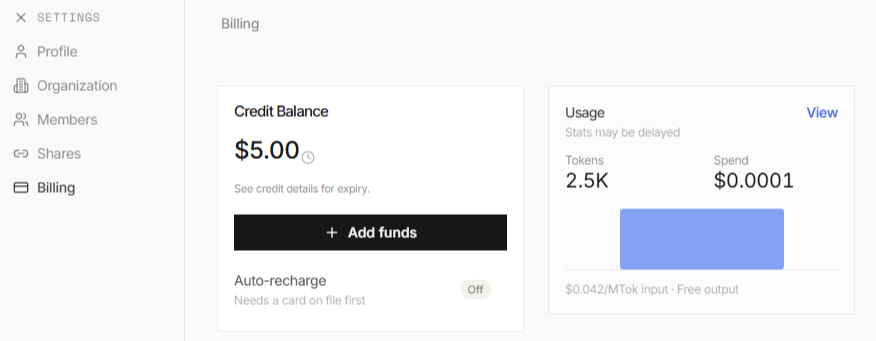
5달러가 얼마나 되는지 감이 잘 안 오는데, 단가를 보면 이야기가 달라진다. 입력 100만 토큰에 0.042달러, 출력은 안 받는다.
5달러면 입력 1억 2천만 토큰쯤이다. 아래 예시 한 번 호출에 579토큰 들었으니 20만 번쯤 부를 수 있다.
자동 충전은 기본이 꺼짐이고 카드를 걸어야 켜진다. 실수로 크게 돌려도 크레딧만 쓰고 멈추니 마음 놓고 눌러봐도 된다.
테스트
고객 문의 하나를 놓고 세 타입을 한 번에 물었다. 문의도 선택지 설명도 전부 한글이다.
{
  "state": "어제 결제한 연간 이용권이 두 번 결제됐습니다. 카드 내역에 같은 금액이 두 건 찍혀 있어요. 메일로 세 번 문의드렸는데 답이 없습니다. 오늘 안에 처리 안 되면 카드사에 이의제기하겠습니다.",
  "model": "jev-latest",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "이 문의는 어느 팀이 맡아야 하는가?",
      "criteria": {
        "결제팀": "중복 결제, 환불, 청구 금액 오류",
        "기술지원팀": "로그인 실패, 오류 화면, 접속 장애",
        "계정팀": "회원가입, 탈퇴, 비밀번호 변경"
      }
    },
    "urgency": {
      "type": "score",
      "instructions": "얼마나 급히 대응해야 하는가?",
      "criteria": ["급하지 않다", "보통이다", "급하다", "당장 처리해야 한다"]
    },
    "wants_refund": {
      "type": "noul",
      "instructions": "고객이 환불을 요구하고 있는가?",
      "criteria": {
        "true": "돈을 돌려달라고 명시적으로 요구한다",
        "false": "문제 해결만 요청하고 환불은 언급하지 않는다"
      }
    }
  }
}
호출은 이렇게 한다. 나는 윈도우에서 Git Bash로 돌렸는데 한글이 섞이니 본문이 깨져서 `There was an error parsing the body`가 떨어졌다. 셸이 인코딩을 바꿔버린 탓이다. JSON을 UTF-8 파일로 저장해서 보내니 바로 됐다.
import os
import requests

resp = requests.post(
    "https://api.typesafe.ai/v1/systemone",
    headers={"Authorization": f"Bearer {os.environ['TYPESAFE_API_KEY']}"},
    json={
        "state": "어제 결제한 연간 이용권이 두 번 결제됐습니다. ...",
        "model": "jev-latest",
        "questions": { ... },   # 위에 쓴 그대로
    },
)

answers = resp.json()["answers"]
print(answers["team"]["choice"], answers["team"]["confidence"])
print(answers["urgency"]["score"])
print(answers["wants_refund"]["noul"])
돌아온 답이다.
결제팀 1.0
2.74
0.24

// response
{
  "model": "jev-1.13.0",
  "answers": {
    "team": {
      "type": "choice",
      "choice": "결제팀",
      "confidence": 1.0,
      "probabilities": { "결제팀": 1.0, "기술지원팀": 0.0, "계정팀": 0.0 }
    },
    "urgency": {
      "type": "score",
      "score": 2.74,
      "confidence": 0.74,
      "legend": { "0": "급하지 않다", "1": "보통이다",
                  "2": "급하다", "3": "당장 처리해야 한다" },
      "probabilities": { "0": 0.0, "1": 0.0, "2": 0.25, "3": 0.75 }
    },
    "wants_refund": { "type": "noul", "noul": 0.24 }
  },
  "usage": { "input_tokens": 579, "output_tokens": 82 }
}
한글은 문제없이 읽는다. 문의도 선택지 이름도 설명도 전부 한글인데 헷갈리지 않았다.
팀 배정은 결제팀에 확률이 전부 몰렸고, 급한 정도는 2.74가 나왔다. 척도 값은 소수로 돌아오고 legend로 각 단계 뜻까지 같이 준다. 순위 매기는 데 바로 쓰기 좋은 모양이다.
걸린 시간은 1.47초. 발표 자료에는 70~500ms라고 적혀 있는데 그건 모델이 계산하는 시간이고, 여기엔 한국에서 미국 서버까지 왕복하는 시간이 붙는다.
wants_refund가 0.24로 나온 게 눈에 띄었다. 중복 결제 문의니까 당연히 환불 요구라고 볼 것 같은데 낮게 나왔다. 이유는 내가 쓴 설명에 있다. "돈을 돌려달라고 명시적으로 요구한다"라고 적어뒀는데, 문의를 다시 보면 처리해달라고 했지 환불해달라는 말은 없다. 카드사 이의제기 얘기는 협박이지 환불 요청이 아니고.
그럼 설명을 바꾸면 달라지나 싶어서, 똑같은 문의에 똑같은 예/아니오 질문을 설명만 바꿔 세 개 던져봤다.
"refund_explicit": { "criteria": { "true": "돈을 돌려달라고 명시적으로 요구한다" } }
"refund_likely":   { "criteria": { "true": "환불이나 결제 취소로 이어질 만한 불만이다" } }
"refund_bare":     { "instructions": "환불 건인가?" }

// 결과
  돈을 돌려달라고 명시적으로 요구한다        0.26
  환불이나 결제 취소로 이어질 만한 불만이다   0.92
  설명 없이 "환불 건인가?"                 0.81
같은 글을 놓고 0.26과 0.92가 나온다. 모델이 헷갈린 게 아니라 각각 정확히 물어본 대로 답한 것이다. 이 문의에 "환불해주세요"라는 말은 실제로 없고, 환불로 이어질 가능성은 실제로 높다. 둘 다 맞는 답이다.
설명을 아예 안 준 세 번째가 0.81인 것도 볼 만하다. 비워두면 모델이 알아서 넓게 잡는다. 그러니 **비워두는 건 중립이 아니라 느슨한 쪽을 고른 것**이다.
그래서 이 모델을 쓸 때 진짜 일은 선택지를 고르는 게 아니라 설명을 쓰는 일이 된다. 숫자는 뭘 넣든 나오니까, 무슨 숫자인지는 쓴 사람만 안다.
그런데, 같은 걸 물어도 매번 똑같진 않다.
  결제팀 1.0    2.74    0.24
  결제팀 1.0    2.77    0.27
  결제팀 1.0    2.76    0.26
  결제팀 1.0    2.79    0.25
  결제팀 1.0    2.75    0.25
선택지를 고르는 건 다섯 번 다 같았고, 소수로 나오는 값은 둘째 자리에서 흔들렸다. 폭은 0.03 안쪽이다.
순위를 매기거나 선을 긋는 용도라면 이 정도는 문제가 안 된다. 다만 "0.25 이상이면 처리" 같은 선을 소수점 둘째 자리에 걸어두면 같은 입력이 날마다 다르게 처리될 수 있다. 선은 넉넉하게 긋는 게 낫겠다.
확률이 몰리는 방식도 볼 만했다. 팀 배정에서 결제팀이 1.0이고 나머지 둘은 **정확히 0.0**이다. 애매한 문의를 따로 넣어보니 그때는 두 곳에 0.89와 0.11로 갈리고 나머지는 여전히 0.0이었다. 아무 데나 확률을 뿌리는 게 아니라 헷갈릴 만한 곳에만 나눠준다.
이게 되면 "0.9 넘는 것만 자동 처리하고 나머지는 사람에게" 같은 선을 그을 수 있다. 일반 모델의 확률값으로는 이 선을 못 긋는다. 그 숫자는 "그 단어를 뱉을 확률"이지 "그 판단이 맞을 확률"이 아니라서다.
RAG에는 어디에 쓸 수 있을까
RAG 구축 시 고려할 것들을 하나씩 파보는 중이라 이걸 어디에 끼울 수 있을지도 생각해봤다.
못 쓰는 자리부터
임베딩은 대체 못 한다. Jev는 숫자 배열을 안 돌려준다. 색인에 저장할 게 없고, 저장할 게 없으면 비슷한 것 찾기도 안 된다. 검색은 미리 계산해둔 벡터끼리 거리를 재는 건데 그 재료가 안 나온다.
후보를 좁히는 단계에도 못 쓴다. 조각이 수십만 개인데 한 덩어리로 넣을 수가 없다. 찾는 일은 여전히 벡터와 키워드가 해야 한다.
그러니 Jev 자리는 이미 좁혀진 다음이다.
쓸 만해 보이는 자리
하나, 리랭킹. 후보 조각마다 "이 조각이 질의에 답하는가"를 예/아니오로 물으면 그 확률이 곧 점수다. 지금 쓰는 크로스인코더 리랭커와 하는 일이 같은 꼴이다. 다만 후보 백 개면 백 번 물어야 한다. 한 번에 넣고 고르게 하는 게 아니다. 순서대로 백 번 부르면 70ms짜리라도 7초니까 묶어서 보내는 게 전제다.
둘, 버릴 줄 아는 검색. 이게 더 끌린다. 지금 리랭커 점수는 순위를 매기는 숫자지 확률이 아니다. 0.7이 무슨 뜻인지 모른다. 그래서 답이 아예 없는 질의에도 상위 다섯 개를 꼬박꼬박 돌려준다. 확률이 보정돼 있으면 "0.3 아래면 결과 없음"이라고 선을 그을 수 있다. 엉뚱한 걸 자신 있게 보여주는 것보다 못 찾았다고 하는 편이 나은 경우가 많다.
셋, 색인 시점 분류. 지난 글에서 문서를 카테고리로 나눠 자르는 실험을 했는데 그 판별이 딱 choice 질문이다. 문서 한 개당 한 번만 부르면 되니 호출 수도 적다.
넷, 답변 검증. 생성한 답이 근거 조각에 실제로 들어 있는 내용인지를 예/아니오로 묻는 것. 근거 없이 지어낸 문장을 걸러내는 자리다.
축을 열 개쯤 정해두고 조각마다 점수를 매겨 저장하면 그게 저차원 임베딩이 되지 않을까 생각해봤다. 질의도 같은 축으로 재서 가까운 걸 찾으면 되니까. 해석이 된다는 점은 매력적이다. 1024차원 벡터는 왜 이게 뽑혔는지 아무도 모르지만, 이건 "환불 축이 0.9라서"가 나온다.
문제는 변별력이다. 조각 하나를 보면 열 개 축 중 실제로 관련 있는 건 한둘이고 나머지는 전부 0 근처다. 그러면 "요금 축만 높은 조각"이 수천 개 생긴다. 수학적으로는 조금씩 다른데 실질적으로는 구분이 안 된다. 1024차원이 낭비처럼 보여도 그 넓이가 조각들을 서로 떨어뜨려 놓는 역할을 하고 있었던 셈이다.
축을 누가 정하느냐도 걸린다. 열 개를 정하려면 어떤 질문이 들어올지 미리 알아야 하는데, 새 주제 문서가 들어오면 담을 축이 없다. 임베딩이 무식해 보여도 축을 안 정해도 된다는 게 핵심 장점이었다.
그래서 대체가 아니라 거르는 축이나 점수 하나를 더 얹는 쪽이 맞아 보인다.
오픈소스는 없을까?
원본 Jev의 가중치는 안 풀렸다. API로만 쓸 수 있다. 대신 발표 일주일 만에 따라 만든 것들이 올라왔다. 2026년 9월 21일 기준으로 눈에 띄는 건 이 정도다.
com-kotobalabs/open-jev-deberta-v3-large
  기반    microsoft/deberta-v3-large
  크기    0.4B
  라이선스 Apache 2.0
  한계    영어 전용, 512토큰(state는 256으로 잘림),
          학습 도메인 세 개(은행 상담·영화 리뷰·위키 예/아니오)
  속도    H100에서 한 state에 질문 10개 28ms
제일 가볍다. 0.4B면 개인 PC에서도 돈다. 쓰는 법도 m.decide(상태, [질문들]) 한 줄이라 붙이기 쉽다. 다만 영어 전용이고 state가 256토큰에서 잘린다.
  기반    Qwen3.5-4B
  크기    0.8B / 4B / 35B MoE
  라이선스 MIT
  성격    전제와 가설을 같이 읽고 함의·모순·중립을 답하는 크로스인코더
  언어    영어 표기
리랭킹, 채점, 조정, 에이전트 판단에 그대로 쓸 수 있다고 소개한다. Qwen 계열이라 한국어 가능성은 있어 보이는데 모델 카드에 명시는 없다.
  성격    Jev의 HTTP API를 그대로 흉내 낸 서버
  모델    Qwen3.6-35B-A3B (NVFP4)
  배포    Modal로 B200에 올리거나 로컬 SGLang에 붙이거나
모델이 아니라 서버다. 원본과 같은 모양으로 요청을 받아 오픈 모델에 태워준다. 코드를 안 고치고 갈아끼울 수 있다는 뜻이라 이게 제일 실용적일 수 있다. README에 적힌 기본값도 참고가 된다. 질문 64개까지, 선택지는 2~64개, JSON 2MiB, 분기당 32,768토큰. 원본 API 문서에는 이런 한도가 안 나와 있어서 대략의 감을 여기서 얻었다. 전체 목록은 재현판 트래커에 모여 있다.
정리하면 한글로 쓸 거면 아직은 원본 API밖에 없다. 공개된 것들은 영어 쪽에 맞춰져 있고 한국어가 되는지 확인된 건 못 찾았다. 데이터를 밖으로 못 보내는 상황이면 Qwen 기반 쪽을 직접 재보는 수밖에 없어 보인다.
마치며
싸고, 빠르고, 한글도 된다. 대신 따져가며 푸는 건 못 한다.
LLM을 밀어내는 물건이라기보다는 LLM에 안 물어도 되는 간단한 판단을 빠르게 하는 물건에 가깝다.
정리하면 아래와 같다.
  판단이 자주 일어난다        한 건에 몇 원이 아니라 몇 만 건에 몇 천 원
  기준이 매번 같다            같은 질문을 계속 묻는다
  답이 몇 가지로 정해진다      팀 이름, 등급, 예/아니오
하나라도 빠지면 굳이 이걸 쓸 이유가 없다.
아직 정확도까지는 안 재봤다. 다음 글에서 공개 문서를 규칙·작은 언어모델·Jev를 같은 판에 올려볼 생각이다.
크레딧 5달러는 한 달 뒤면 사라진다. 손에 잡히는 판단거리가 있으면 그전에 한 번 넣어보시길.
'개발 > AI' 카테고리의 다른 글
| sqlite FTS5로 검색 서버 메모리 절반 줄이기 (0) | 2026.08.14 |
|---|---|
| RAG 검색 개선기: 회고 (0) | 2026.08.11 |
| RAG 검색 개선기: 평가지표 선정 (0) | 2026.08.04 |
| RAG 검색 개선기: 크로스 인코더 리랭커를 사용해보자 (0) | 2026.07.23 |
| Hermes-Agent 설치 및 사용 후기 (1) | 2026.07.14 |
- Total
- Today
- Yesterday
- 티스토리챌린지
- OpenAI
- Redis
- AWS EC2
- 질의처리
- CloudFront
- Log
- docker
- 후쿠오카
- elasticsearch
- cache
- Kotlin
- rag
- EKS
- 오블완
- AWS
- S3
- ChatGPT
- serverless
- 검색 품질
- terraform
- java
- lambda
- GIT
- bm25
- springboot
- 인프런
- Spring
- 온디바이스 AI
- 스프링부트
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |