
티스토리 뷰
지난 글에서 Jev를 가입하고 이것저것 눌러봤다. 싸고 빠르고 한글도 읽는다는 건 확인했는데, 정확도는 안 재봤다.
이번엔 실제 일을 하나 시켜봤다. 문서를 보고 어떤 카테고리인지 맞히는 일이다.
요즘 문서를 카테고리로 나눠서 다르게 자르는 청킹 실험을 하고 있는데, 거기서 제일 오래 붙들린 게 "이 문서가 어느 카테고리인가"를 판별하는 단계였다. 여럿 중 하나를 고르는 일이라 Jev의 choice 질문에 딱 맞는다. 문서 하나에 한 번만 부르면 되니 호출 수도 적다.
지난 글 끝에 규칙, 작은 언어모델, Jev를 같은 판에 올려보겠다고 적었는데 그건 못 했다. 재다 보니 서로 입력 조건이 달라서 같은 표에 올릴 수가 없었다.
그래서 이번 글은 Jev만 놓고 본다. 얼마나 맞히는지, 같이 나오는 확률은 믿을 만한지 순서로 적어둔다.
실험 준비
문서는 공개 문서 20건을 골랐다. 정부 공고문, 보도자료, 법령 개정안, 매뉴얼, 발표자료, 연구보고서, 신청 양식 같은 것들이다. 정답은 본문을 직접 읽고 달았다. 파일 이름이나 확장자는 근거로 쓰지 않았다. 규칙으로 판별할 때 보는 게 바로 그것들이라, 그걸로 정답을 달면 규칙에 유리한 답안지가 된다.
문서를 통째로 넣고 싶었는데 입력 한도가 있었다. 직접 올려가며 재봤다.
  보낸 길이    결과    입력 토큰
  3만 자       통과    21,703
  4만 자       통과    30,573
  4.5만 자     막힘    max_tokens_exceeded
상한은 32,768 토큰으로 보인다. 한글로 4만 자 조금 넘는 정도다.
20건 중에는 93만 자짜리 연구보고서도 있었다. 그래서 3만 자를 넘는 문서는 앞부분만 잘라서 넣었다. 20건 중 10건이 잘렸다.
선택지는 일곱 개다.
  발표자료     장표 단위로 구성된 문서
  표 형식      표나 칸으로 된 데이터가 중심. 양식, 내역서, 점검표
  법령         조문과 항으로 나뉜 문서
  공공문서     공공기관이 낸 공고, 보도자료, 정책 계획
  계층 목차    장절 번호가 깊게 매겨진 매뉴얼, 가이드라인
  논문         초록, 서론, 방법, 결과 구조를 가진 학술 논문
  통째로       너무 짧아 나눌 필요가 없는 문서
같은 조건으로 20건을 두 번 돌렸다. 한 번만 재면 그 확률이 우연히 나온 건지 알 수가 없어서다.
선택지에서 "기타"를 뺀 이유
원래 청킹 규칙에는 카테고리가 하나 더 있다. 위 일곱 개 어디에도 안 들어가는 문서를 받는 자리다. 특별한 구조 없이 줄글로 이어지는 보고서나 안내문이 여기로 간다. 분류표를 만들면 흔히 넣는 "기타" 같은 칸이다.
처음엔 이것까지 넣어서 여덟 개로 물었다. 결과는 이랬다.
  기타가 정답인 문서    4건 중 0건
  나머지 문서           16건 중 16건
기타만 하나도 못 맞혔다.
생각해보면 당연한 결과다. 다른 카테고리는 "표가 많다", "조항이 있다"처럼 있는 특징으로 정의된다. 그런데 기타는 "어느 것도 아니다"로 정의된다. 고를 근거가 없는 선택지인 셈이다. 게다가 Jev는 무조건 하나를 고른다.
사람처럼 "애매하니까 기타"가 안 된다.
그래서 기타를 선택지에서 빼고, 볼 것을 둘로 나눴다.
  카테고리가 뚜렷한 문서 16건      →  맞는 걸 고르는가
  어디에도 안 들어가는 문서 4건    →  확률이 낮게 나오는가
뒤쪽이 더 궁금했다. 같이 나오는 확률이 정말 "맞을 가능성"이라면, 확률이 낮다는 걸 "해당하는 게 없다"는 신호로 쓸 수 있기 때문이다.
분류 결과
카테고리가 뚜렷한 16건은 두 번 모두 다 맞혔다.
               1회차          2회차
  맞힌 수      16/16          16/16
  확률 범위    0.66 ~ 1.00    0.69 ~ 1.00
확률은 대부분 0.98 이상이었고, 제일 낮은 게 0.66이었다.
다만 이걸 100%라고 부르기는 어렵다. 16건의 정답을 카테고리별로 세면 이렇다.
  공공문서        6건
  계층 목차       4건
  발표자료        2건
  법령            2건
  표 형식         2건
  논문, 통째로    0건
논문과 통째로는 정답인 문서가 아예 없다. 일곱 개 중 다섯 개만 확인한 셈이고, 그마저도 두세 건씩이다.
확률로 걸러낼 수 있을까
남은 4건은 어디에도 안 들어가는 문서다. 그래도 Jev는 하나를 골라서 답한다. 이때 확률이 어떻게 나오는지 봤다.
  문서                        Jev의 답    1회차    2회차
  위탁연구 최종보고서         공공문서    0.39     0.42
  논문성과 분석연구 보고서    공공문서    0.42     0.49
  논문 질적성과 분석연구      논문        0.60     0.55
  결핵검진 입력방법 안내      표 형식     0.96     0.96
넷 중 셋이 0.6 이하로 나왔다. 앞의 16건이 대부분 0.98 이상이었던 것과 확실히 갈린다.
그렇다면 확률이 낮은 건 "해당 없음"으로 돌리면 되지 않을까? 기준선을 바꿔가며 20건 전체를 다시 채점해봤다.
  기준선    1회차          2회차
  없음      16/20 (80%)    16/20 (80%)
  0.5       18/20 (90%)    18/20 (90%)
  0.6       18/20 (90%)    19/20 (95%)
  0.65      19/20 (95%)    19/20 (95%)
  0.7       18/20 (90%)    17/20 (85%)
  0.8       16/20 (80%)    16/20 (80%)
기준선이 없으면 80%인데, 0.65에 그으면 95%가 된다. 모델을 바꾼 게 아니라 같이 오던 확률을 쓴 것뿐이다. 기준선을 더 올리면 맞은 것까지 버려서 다시 내려간다.
지난 글에서 일반 모델의 확률값으로는 이런 선을 못 긋는다고 적었다. 그 숫자는 "그 단어를 뱉을 확률"이지 "그 판단이 맞을 확률"이 아니라서다. Jev에서는 실제로 선이 그어졌다.
다만 그을 수 있는 폭이 좁다.
  어디에도 안 들어가는 문서 중 가장 높은 확률    0.60
  카테고리가 뚜렷한 문서 중 가장 낮은 확률       0.66
0.06 차이다. 그리고 같은 입력인데도 돌릴 때마다 확률이 조금씩 움직인다.
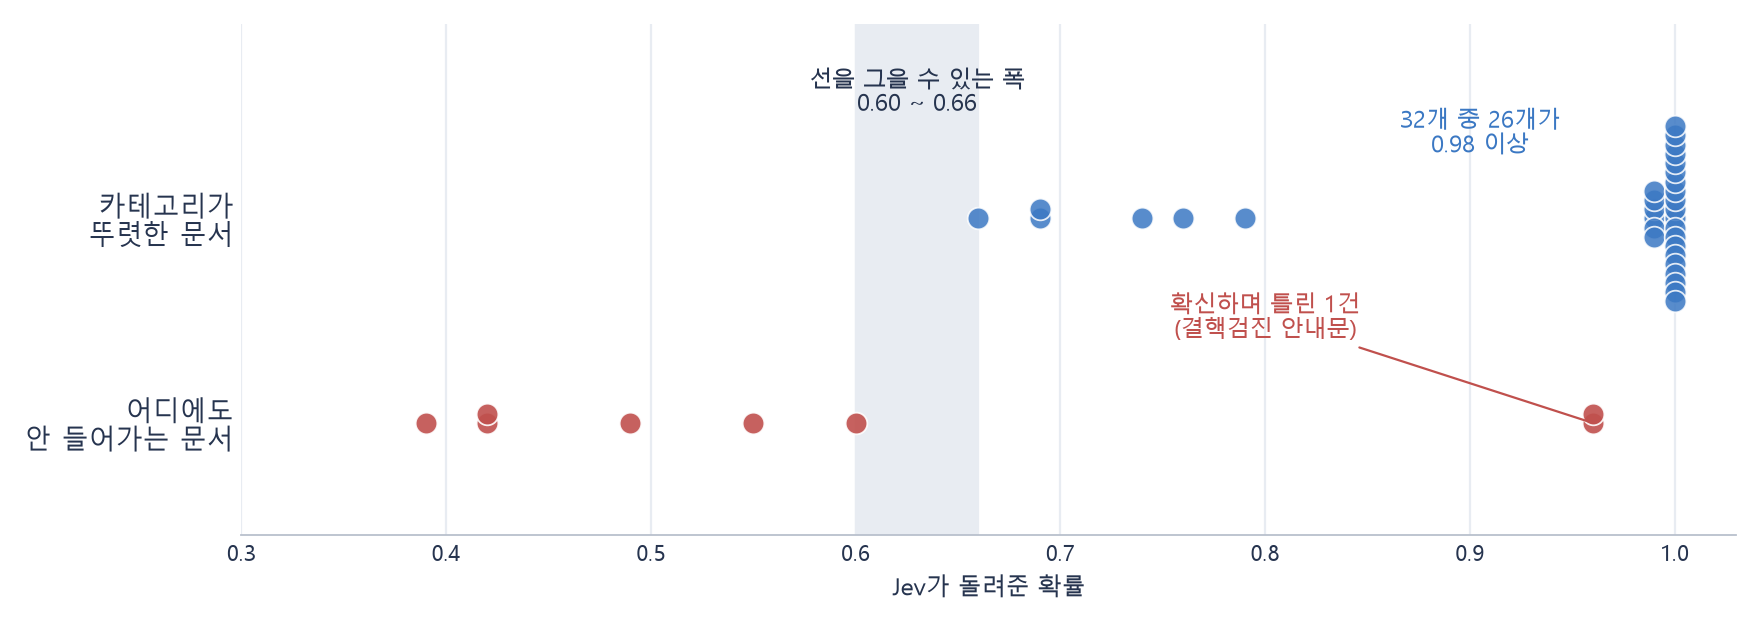
0.60이 다음엔 0.55가 되는 식이다. 그래서 20건만 가지고 기준선을 몇으로 하라고 정할 수는 없었다.
확률로도 못 잡는 것
두 가지가 있었다. 하나는 확신하며 틀리는 경우다. 위 표의 결핵검진 안내문은 두 번 다 0.96으로 표 형식이라고 답했다. 문서를 열어보니 앞쪽은 입력 절차를 설명하는 줄글이고, 뒤에 점검표가 여섯 개 붙어 있었다. 표가 실제로 많아서 사람이 봐도 갈릴 만한 문서긴 하다. 어쨌든 이런 건 확률로 못 거른다. 모르는 건 확률에 드러나는데, 잘못 아는 건 안 드러난다.
다른 하나는 입력을 길게 줄수록 틀릴 확률이 올라갔다. 어디에도 안 들어가는 연구보고서 한 건을 길이만 바꿔서 세 번씩 넣어봤다.
  보낸 길이    Jev의 답    확률 (세 번)
  3,000자      공공문서    0.39 / 0.53 / 0.40
  10,000자     공공문서    0.36 / 0.37 / 0.41
  30,000자     논문        0.59 / 0.57 / 0.52
앞부분만 줬을 땐 0.4 근처다. 앞부분은 표지와 제출문이라 어떤 문서인지 잘 드러나지 않는다. 그러니 확률이 낮은 게 맞다.
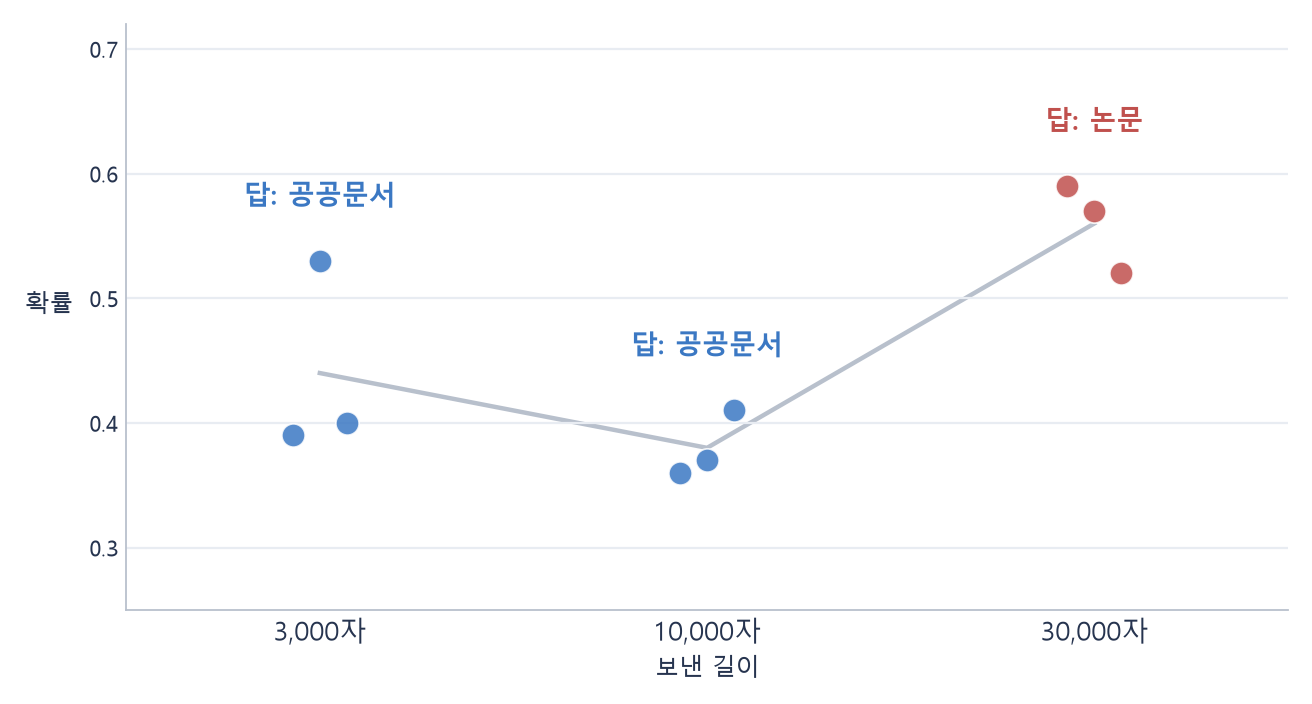
그런데 3만 자를 주면 답이 논문으로 바뀌고 확률도 0.55 근처로 오른다. 논문 성과를 분석한 보고서라 본문에 논문 얘기가 잔뜩 나오기 때문이다. 많이 읽히면 더 정확해질 줄 알았는데 반대였다.
0.55면 위에서 본 기준선 근처라 걸러내기도 어려워진다.
한 건으로 본 거라 일반화하긴 이르다. 그래도 무조건 길게 넣는 게 답은 아니었다.
비용과 속도
이번 실험에 실제로 쓴 값이다. 단가는 입력 100만 토큰에 0.042달러다.
                       입력 토큰    비용
  문서 한 건 (평균)    1.6만        0.0007달러
  20건 한 번           31.8만       0.0134달러
  이번 실험 전체       185만        0.078달러
설계를 바꿔가며 여러 번 돌린 걸 다 합쳐도 100원 정도다. 문서 천 건으로 환산하면 0.67달러니까 천 원이 안 된다.
속도는 한 건에 0.36초에서 1.40초 사이였다. 같은 입력인데도 돌릴 때마다 평균이 두 배쯤 차이 나서, 한 건에 몇 초라고 말하기는 어렵다.
재밌는 건 입력이 3천 토큰일 때와 2만 토큰일 때 둘 다 0.4초대였다는 것이다. 입력이 일곱 배인데 시간이 같다. 걸리는 시간의 대부분이 계산이 아니라 서버까지 오가는 데 쓰인다는 뜻이다.
마치며
정리하면 이렇다.
  카테고리가 뚜렷한 문서       16건 모두 맞혔다 (두 번 다)
  어디에도 안 들어가는 문서    4건 중 3건은 확률이 낮게 나왔다
  확률 기준선을 걸면           80%에서 95%로 오른다
  확률로 못 잡는 것            0.96으로 확신하며 틀린 1건
제일 크게 배운 건 선택지를 짜는 방법이었다. 기타는 선택지에 넣는 게 아니라, 확률이 낮을 때 떨어지는 자리로 두는 게 맞았다. 사람한테 자연스러운 분류표가 모델한테도 자연스러운 건 아니다.
지난 글에서 Jev의 "버릴 줄 아는 검색"이 끌린다고 적었다. 답이 없는 질의에는 결과 없음이라고 말하는 검색이다. 이번 결과가 그 근거가 될 것 같다. 고를 게 없는 문서에서 확률이 실제로 낮게 나왔으니까.
다만 0.96짜리 오답이 있었으니, 확률만 보고 자동으로 버리기보다는 참고 신호로 먼저 쓰는 게 안전해 보인다.
기회가 된다면, 표본을 늘려서 기준선을 정하고, 입력 조건을 맞춰서 규칙과 나란히 재볼 생각이다.
'개발 > AI' 카테고리의 다른 글
| 문서마다 다르게 자르면 RAG 성능이 좋아질까 : 템플릿 청킹(Template Chunking) 테스트 (0) | 2026.10.01 |
|---|---|
| 문장 대신 답만 돌려주는 모델 : Jev 시작해보기 (1) | 2026.09.21 |
| sqlite FTS5로 검색 서버 메모리 절반 줄이기 (0) | 2026.08.14 |
| RAG 검색 개선기: 회고 (0) | 2026.08.11 |
| RAG 검색 개선기: 평가지표 선정 (0) | 2026.08.04 |
- Total
- Today
- Yesterday
- Redis
- S3
- EKS
- AWS
- 검색 품질
- 인프런
- terraform
- 후쿠오카
- docker
- Log
- Spring
- bm25
- 온디바이스 AI
- 질의처리
- serverless
- java
- lambda
- CloudFront
- AWS EC2
- elasticsearch
- Kotlin
- 스프링부트
- ChatGPT
- OpenAI
- springboot
- 티스토리챌린지
- 오블완
- cache
- rag
- GIT
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |